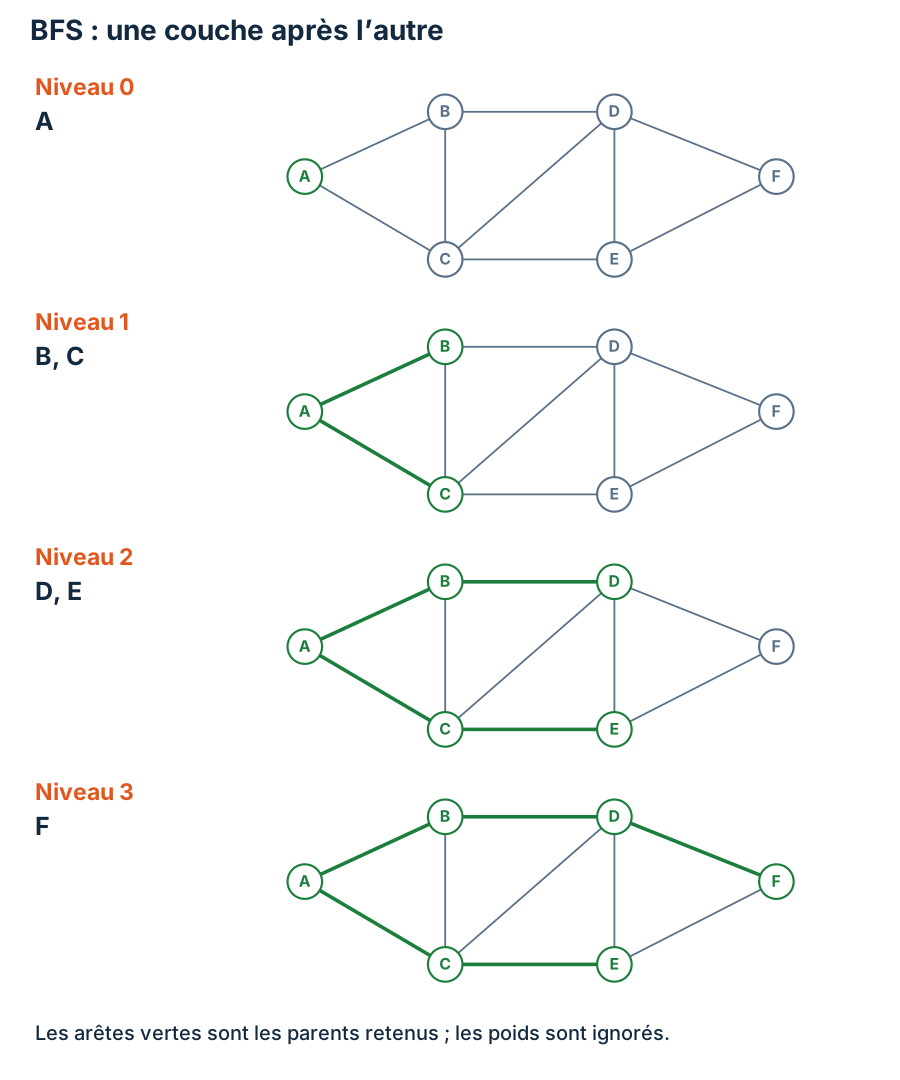
Un message part du dépôt A et peut franchir une liaison à chaque relais. Quels points seront atteints après une étape, puis après les suivantes ? Le parcours en largeur répond exactement à cette question. Il explore d'abord les voisins proches en nombre de liaisons, puis s'éloigne progressivement. Nous allons suivre sa file d'attente et comprendre pourquoi sa première découverte donne déjà une distance minimale.
La première découverte BFS minimise les étapes.
1. Définir la distance que l'on cherche
BFS et niveau. BFS, pour parcours en largeur, explore les sommets accessibles depuis une source par nombre croissant de liaisons. Le niveau d'un sommet est la longueur minimale d'un parcours depuis cette source, en comptant chaque liaison pour une étape. Un sommet inaccessible n'a pas de niveau fini.
Notre réseau possède des poids, mais nous les ignorons volontairement dans ce chapitre. Une liaison coûteuse et une liaison peu coûteuse demandent chacune un relais. Ce choix convient pour compter des correspondances ou des sauts de communication. Il ne convient pas pour minimiser une facture lorsque les poids diffèrent.
Le sommet de départ reçoit le niveau zéro : atteindre A depuis A ne demande aucun déplacement. Ses voisins reçoivent le niveau suivant. Une fois ces voisins traités, on connaît les points accessibles avec une étape supplémentaire. L'algorithme doit empêcher qu'un même sommet soit ajouté sans fin lorsque le réseau contient des cycles.
2. La file impose l'ordre des découvertes
File et marquage. Une file est une collection où le premier élément ajouté est le premier retiré. Marquer un sommet signifie mémoriser qu'il a déjà été découvert. Un parent est le sommet depuis lequel cette première découverte a eu lieu ; il permet de reconstruire un chemin.
La file matérialise une attente équitable : les sommets découverts plus tôt passent avant les nouveaux arrivants. Lorsque A découvre B puis C, B est traité avant C. Les nouveaux voisins de B sont ajoutés derrière C. Ainsi, les sommets du niveau suivant ne dépassent jamais ceux du niveau courant.
Le marquage se fait au moment de l'ajout, pas au moment du retrait. Si deux sommets découvrent le même voisin avant son traitement, le second voit déjà la marque et ne l'ajoute pas une nouvelle fois. Cette précision évite les doublons dans la file et garantit qu'un seul parent est fixé lors de la première découverte.
Pour chaque sommet v : distance[v] ← infini ; parent[v] ← aucun
distance[source] ← 0
Enfiler source
Tant que la file n'est pas vide :
    u ← défiler
    Pour chaque voisin v de u :
        Si distance[v] vaut infini :
            distance[v] ← distance[u] + 1
            parent[v] ← u
            enfiler v
3. Suivre le réseau sans sauter les étapes
Nous parcourons les voisins par ordre alphabétique. Ce choix rend la trace reproductible. Il peut modifier les parents lorsque plusieurs chemins de même longueur existent, mais pas les distances finales. Après le retrait de A, la file contient B puis C. B découvre D. C découvre E, car D est déjà marqué. D découvre ensuite F.
Les poids sont ignorés pour compter les étapes. Cliquer pour agrandir.
BFS : distances en nombre d’arêtes
Retrait
File après découverte
A
B
C
D
E
F
A
B → C
0
1
1
∞
∞
∞
B
C → D
0
1
1
2
∞
∞
C
D → E
0
1
1
2
2
∞
D
E → F
0
1
1
2
2
3
E
F
0
1
1
2
2
3
F
vide
0
1
1
2
2
3
Les niveaux finaux sont A : 0 ; B et C : 1 ; D et E : 2 ; F : 3. Un sommet reste dans sa première couche même si un autre trajet le rejoint ensuite. Par exemple, C voit D depuis le même niveau que B : ce détour donne la même longueur, mais il ne remplace pas le parent déjà choisi.
Le chemin reconstruit vers F est A–B–D–F. Pour l'obtenir, on suit les parents depuis F : D, puis B, puis A. Cette lecture remonte du but vers la source ; on inverse ensuite la séquence. Conserver uniquement les distances ne suffit pas à connaître ce chemin particulier sans effectuer une recherche supplémentaire.
4. Pourquoi la première découverte est minimale
Invariant. Un invariant est une propriété qui reste vraie aux moments importants d'un algorithme. Pour BFS, les sommets en attente sont rangés par niveaux croissants. Les nouvelles découvertes effectuées depuis un sommet de niveau k reçoivent le niveau k + 1.
Au départ, la propriété est vraie puisque seule la source attend. Supposons qu'elle soit vraie avant de retirer u. Ses voisins encore inconnus sont placés à la fin avec un niveau supérieur d'une unité. Les sommets déjà présents, découverts plus tôt, restent devant eux. La file conserve donc l'ordre des niveaux.
Supposons maintenant qu'un sommet v soit découvert avec une longueur trop grande. Un chemin plus court vers v passerait par un prédécesseur dont le niveau est plus petit. Ce prédécesseur aurait été traité avant le sommet qui vient de découvrir v. Il aurait donc découvert v plus tôt, contradiction. La première longueur obtenue est ainsi minimale.
Ce raisonnement utilise le fait que chaque liaison ajoute exactement une étape. Si les coûts sont différents, le sommet découvert le plus tôt peut avoir un coût élevé. Sur notre réseau, le chemin BFS vers F coûte 15 unités, alors que le trajet A–C–B–D–E–F en coûte 13. La preuve ne porte jamais sur cette somme pondérée.
5. Coût, arrêt anticipé et sommets inaccessibles
Complexité. La complexité temporelle exprime comment le nombre d'opérations augmente avec la taille des données. Ici, n compte les sommets et m les liaisons. La mémoire auxiliaire est celle ajoutée par l'algorithme, en plus du stockage du graphe.
Avec des listes d'adjacence, chaque sommet accessible entre une seule fois dans la file. Chaque entrée de voisinage correspondante est examinée une fois. L'initialisation concerne tous les sommets. Le coût total est O(n + m), avec O(n) de mémoire auxiliaire pour les distances, les parents et la file. Une arête non orientée est examinée dans les deux sens, ce qui ne change pas cet ordre de grandeur.
Avec une matrice, trouver les voisins d'un sommet demande de parcourir toute une ligne. Une exploration complète coûte alors O(n²). Le même nom d'algorithme ne suffit donc pas à garantir la même borne : la représentation compte. Une file doit aussi permettre l'ajout et le retrait en temps constant ; décaler un grand tableau à chaque retrait ajouterait du travail inutile.
Si l'on cherche seulement un chemin vers une cible, on peut arrêter lors de sa première découverte. Sa distance est déjà prouvée minimale. En revanche, les autres distances ne sont pas nécessairement toutes calculées. Si la file se vide avant d'atteindre la cible, elle est inaccessible depuis la source. Il faut afficher cette situation explicitement, sans essayer de suivre des parents inexistants.
6. Étendre le mécanisme avec prudence
Exploration à plusieurs sources. On peut initialiser plusieurs sommets au niveau zéro et les placer dans la même file. Chaque sommet reçoit alors sa distance à la source initiale la plus proche, en nombre de liaisons.
Cette variante sert par exemple à chercher le point de secours le plus proche dans un réseau où chaque déplacement compte pareil. On conserve éventuellement l'identité de la source responsable de chaque découverte. Les égalités dépendent encore de l'ordre d'initialisation. Pour compter toutes les solutions minimales, un seul parent ne suffit plus : il faut enregistrer les contributions pertinentes sans confondre chemins et simples visites.
Dans un graphe orienté, BFS suit uniquement les arcs sortants. Un sommet peut être accessible depuis A sans pouvoir revenir vers A. Pour trouver les composantes connexes d'un graphe non orienté, on relance l'exploration depuis un sommet encore inconnu. Dans un graphe orienté, cette procédure ne calcule pas directement les composantes fortement connexes.
À retenir. BFS minimise le nombre de liaisons. La file maintient les couches dans le bon ordre. Le marquage intervient dès l'ajout. Les parents reconstruisent un chemin minimal, mais pas nécessairement le seul. Les poids différents demandent un autre outil.
Niveau du voisin découvert = niveau courant + 1.
Exercices corrigés
Exercice 1 : Lire la file
Après avoir traité B dans notre parcours depuis A, quels sommets attendent et dans quel ordre ?
Voir le corrigéMasquer le corrigé
La file contient C puis D. C attendait déjà après l'exploration de A ; D vient d'être découvert depuis B. D ne passe pas devant C. Cette discipline conserve le traitement des couches dans l'ordre.
Exercice 2 : Reconstruire un chemin
Retrouvez le chemin choisi vers F à partir des parents, puis expliquez le sens de lecture.
Voir le corrigéMasquer le corrigé
Les parents donnent F ← D ← B ← A. On remonte donc vers la source avant d'inverser la séquence. Le chemin produit est A–B–D–F, de longueur 3. Les poids ne participent pas à cette reconstruction.
Exercice 3 : Changer l'ordre des voisins
Si C est examiné avant B depuis A, la distance de D peut-elle changer ?
Voir le corrigéMasquer le corrigé
Non. B et C sont tous deux au niveau 1 et peuvent atteindre D au niveau 2. Le parent retenu peut devenir C, selon l'ordre des découvertes. La longueur minimale reste identique, même si le chemin reconstruit change.
Exercice 4 : Diagnostiquer une erreur
Un programme marque les sommets seulement lorsqu'il les retire de la file. Pourquoi cette variante peut-elle ajouter des doublons ?
Voir le corrigéMasquer le corrigé
Un sommet déjà en attente paraît encore inconnu à ses autres voisins. Ceux-ci peuvent l'enfiler de nouveau avant son premier retrait. Marquer dès l'ajout évite ce problème et fixe une unique première découverte, indispensable à la trace simple étudiée ici.