Un dessin aide à comprendre un réseau ; un programme a besoin d'une structure de données. Le bon stockage dépend des opérations fréquentes : vérifier une liaison, parcourir les voisins ou examiner toutes les arêtes. Nous allons représenter le même réseau de plusieurs manières. Les réponses resteront identiques, mais le travail nécessaire pour les obtenir changera sensiblement.
Choisir le stockage selon les opérations dominantes.
1. Fixer les conventions avant de remplir un tableau
Représentation. Une représentation de graphe est une organisation des données qui permet de retrouver les sommets et les liaisons. Nous notons n le nombre de sommets et m le nombre d'arêtes, ou d'arcs pour un graphe orienté. La mémoire mesure les données stockées ; le temps mesure les opérations effectuées. La notation O(f) indique une borne de croissance proportionnelle à f, à un facteur constant près lorsque les données deviennent grandes. Elle ne donne pas un temps en secondes.
Les étiquettes A, B, C, D, E, F sont pratiques pour lire un exemple. Une machine peut leur associer des indices et conserver une table de correspondance. L'ordre des lignes doit être annoncé et rester le même dans tous les tableaux. Une permutation des sommets change la présentation d'une matrice, pas le graphe qu'elle représente.
Nous travaillons d'abord avec un graphe simple. Si plusieurs liaisons relient les mêmes extrémités, il faut décider si elles sont conservées séparément. Un réseau routier peut avoir plusieurs routes entre deux lieux ; un simple tableau contenant une seule valeur par paire ne décrit pas automatiquement chacune de ces routes. Le choix du modèle précède celui du tableau.
2. La matrice d'adjacence
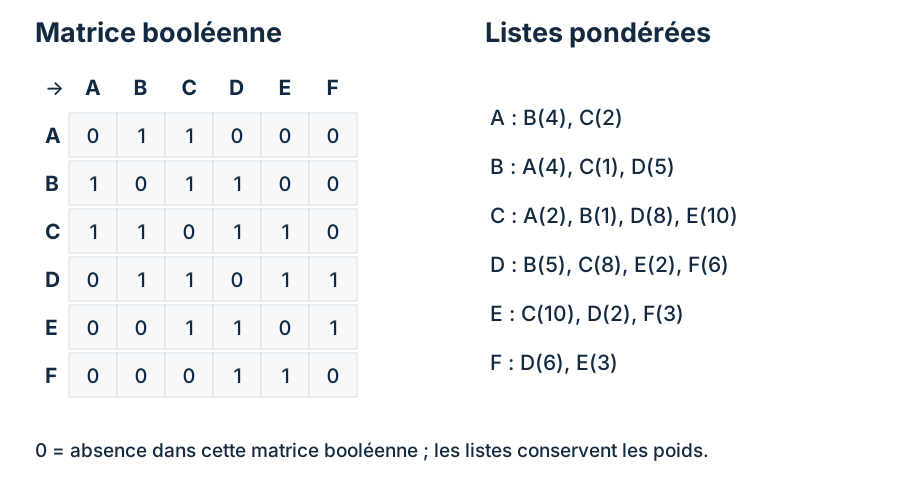
Matrice d'adjacence. C'est un tableau carré avec une ligne et une colonne par sommet. Dans sa version booléenne, la case de ligne u et de colonne v indique si la liaison u vers v existe. Dans un graphe non orienté, la matrice est symétrique : la liaison existe dans les deux sens.
Pour tester AB, on lit directement la case correspondante. On n'a pas besoin de chercher B dans une collection. Cette opération prend un temps constant avec un tableau directement indexé. En revanche, obtenir tous les voisins de A demande de parcourir sa ligne entière, y compris les nombreuses cases vides éventuelles.
L’ordre des sommets est A, B, C, D, E, F. Cliquer pour agrandir.
Pour les poids, on peut conserver un tableau de valeurs et une indication de présence. Une autre convention utilise l'infini pour représenter une liaison absente. Il faut alors éviter de confondre absence et poids nul. Un arc de poids nul est parfaitement possible : il existe, mais son utilisation n'ajoute aucun coût.
La matrice initiale d'un calcul de distances utilise généralement zéro sur la diagonale pour le trajet vide de u vers u. Ce zéro ne prouve pas l'existence d'une boucle dans les données. Un tableau d'adjacence et un tableau de distances peuvent se ressembler tout en ayant des significations différentes ; écrivez toujours la convention dans le titre ou la légende.
3. Les listes d'adjacence
Liste d'adjacence. À chaque sommet on associe une collection de ses voisins. Dans un graphe pondéré, chaque entrée contient aussi le poids de la liaison. Dans un graphe orienté, nous stockons par défaut les arcs sortants.
Dans notre réseau, la collection de A contient B avec le poids 4 et C avec le poids 2. Celle de C contient A, B, D et E avec leurs poids respectifs. Une arête non orientée apparaît dans deux collections : une fois à chaque extrémité. Il faut en tenir compte lorsqu'on recompte les arêtes à partir du stockage.
Les listes évitent de réserver une case pour chaque liaison inexistante. Leur taille totale est proportionnelle au nombre de sommets et d'arêtes, soit O(n + m). Le terme n reste nécessaire : un sommet sans voisin doit quand même être représenté. Parcourir les voisins de u coûte O(degré(u)), sans traverser tous les autres sommets.
En revanche, rechercher une liaison précise dans une liste non triée peut demander d'examiner tous les voisins de u. Un ensemble de hachage ou un tableau trié change ce coût et ajoute ses propres contraintes. Quand nous annoncerons une complexité pour BFS ou DFS, « listes d'adjacence » désignera une structure permettant d'énumérer efficacement les entrées, sans supposer une recherche magique en temps constant.
4. La liste d'arêtes et la matrice d'incidence
Liste d'arêtes et incidence. Une liste d'arêtes enregistre chaque liaison avec ses extrémités et son poids. Une matrice d'incidence possède une ligne par sommet et une colonne par liaison. Elle indique quelles extrémités appartiennent à chaque liaison.
La liste d'arêtes convient bien lorsque l'algorithme doit examiner ou trier toutes les liaisons. Kruskal triera ainsi les arêtes selon leur poids. Bellman-Ford peut parcourir successivement tous les arcs. En revanche, trouver les seuls voisins de A dans une liste brute oblige à inspecter des liaisons qui ne concernent pas A.
Pour notre graphe non orienté sans boucle, la colonne de AB porte une unité sur les lignes A et B, et zéro ailleurs. Dans une convention orientée signée, on inscrit −1 au départ et +1 à l'arrivée. La colonne d'un arc encode alors son sens. Ces signes ne sont pas des poids : ils décrivent les extrémités.
La matrice d'incidence utilise n × m cases. Elle est particulièrement utile pour écrire des contraintes de conservation, par exemple dans un problème de flot. Elle n'est généralement pas le meilleur stockage pour explorer les voisins. Les boucles exigent une convention spécifique, car la contribution entrante et sortante s'annule dans la version signée.
5. Comparer les coûts sur la même question
Graphe clairsemé ou dense. Un graphe est dit clairsemé lorsque le nombre de liaisons reste faible devant le nombre de paires possibles. Il est dense lorsque beaucoup de ces paires sont reliées. Cette distinction décrit une tendance ; elle ne remplace pas la mesure de n et m.
Coûts des structures simples décrites
Structure
Stockage
Tester u–v
Énumérer les voisins
Matrice
O(n²)
O(1)
O(n)
Listes non triées
O(n + m)
O(degré(u))
O(degré(u))
Liste d’arêtes
O(n + m)
O(m)
O(m)
Incidence dense
O(nm)
Pas direct
Examiner les colonnes
La notation O décrit ici une borne de croissance, pas une durée en secondes. Les constantes, l'organisation mémoire et le langage influencent le temps réel. La matrice reste parfois agréable pour un petit graphe dense, même si les listes sont préférables pour un grand réseau clairsemé. Il faut comparer les opérations dominantes de l'application, pas choisir une structure uniquement parce qu'elle semble plus simple à dessiner.
Pour notre réseau, la matrice d'adjacence contient 36 cases. Les listes contiennent 18 entrées de voisinage, auxquelles s'ajoutent les 6 collections de sommets. La matrice d'incidence contient 54 cases. Ces nombres comptent des emplacements logiques ; ils ne sont pas des tailles en octets, car les formats des valeurs et les frais de gestion ne sont pas précisés.
6. Construire puis vérifier la représentation
Créer une collection vide pour chaque sommet
Pour chaque liaison (u, v, poids) :
    vérifier que u et v existent
    ajouter (v, poids) aux voisins de u
    si le graphe est non orienté :
        ajouter aussi (u, poids) aux voisins de v
Un contrôle utile recompte les entrées. Dans notre graphe non orienté, chaque arête doit apparaître deux fois avec le même poids. Dans un graphe orienté, un arc apparaît seulement dans la collection de son départ. Ajouter systématiquement la liaison inverse détruirait le sens des données. Les sommets isolés doivent être conservés lors de toute conversion.
Pour passer des listes à une matrice, on initialise d'abord toutes les cases à « absent », puis on remplit les liaisons présentes. Ce travail coûte O(n² + m), car le tableau carré doit exister avant le remplissage. Changer de représentation n'est donc pas gratuit. Lorsque plusieurs algorithmes se succèdent, on peut conserver différentes vues, à condition de les mettre à jour ensemble si les données changent.
À retenir. La matrice accélère le test d'une liaison précise. Les listes accélèrent l'énumération des voisins sur un réseau clairsemé. La liste d'arêtes convient au balayage global et au tri. La matrice d'incidence exprime bien les relations entre sommets et liaisons. Toujours distinguer absence, zéro et diagonale.
Écrivez les voisins pondérés de A et dites pourquoi AB apparaît aussi dans la liste de B.
Voir le corrigéMasquer le corrigé
A possède les entrées (B, 4) et (C, 2). Le réseau est non orienté : l'arête AB autorise aussi B vers A. Sa seconde occurrence est une duplication de stockage, pas une nouvelle arête.
Exercice 2 : Compter les emplacements
Comparez les emplacements logiques des matrices d'adjacence et d'incidence sur notre réseau.
Voir le corrigéMasquer le corrigé
Avec 6 sommets et 9 arêtes, la première contient 6 × 6 = 36 cases ; la seconde 6 × 9 = 54. On ne peut pas en déduire un nombre d'octets sans connaître les types et la représentation physique.
Exercice 3 : Conserver un poids nul
Une conversion remplace les cases nulles d'une matrice pondérée par « liaison absente ». Quel risque introduit-elle ?
Voir le corrigéMasquer le corrigé
Elle supprime les liaisons de poids nul, pourtant autorisées dans le modèle. Il faut un indicateur de présence séparé ou une valeur sentinelle distincte, comme l'infini. La diagonale doit également être interprétée selon sa convention.
Exercice 4 : Choisir une structure
Un programme examine successivement toutes les liaisons pour les trier. Quel stockage direct proposez-vous ?
Voir le corrigéMasquer le corrigé
Une liste d'arêtes stockant chaque liaison une seule fois permet de trier directement les enregistrements. Des listes d'adjacence non orientées demanderaient d'éviter les doublons avant le tri. Ce choix prépare notamment le fonctionnement de Kruskal.