Chapitre 1 disponible · Cours en construction. Découvrir l’intelligence artificielle : modèles, apprentissage, données, évaluation, IA générative et usage responsable.
Objectifs du chapitre
- Distinguer IA, apprentissage automatique et IA générative.
- Comprendre entraînement, validation et inférence.
- Évaluer une sortie avec des critères adaptés.
1. Que désigne l’intelligence artificielle ?
L’intelligence artificielle, ou IA, regroupe des approches permettant à des systèmes de réaliser des tâches comme classer, prédire, reconnaître ou générer des contenus. Le terme ne désigne pas un seul programme ni une preuve de conscience. Pour comprendre un système, demandez quelle tâche il réalise, quelles informations il utilise et comment sa performance est évaluée.
Certains systèmes utilisent des règles écrites explicitement. L’apprentissage automatique construit un modèle à partir d’exemples. Un modèle est une représentation calculable qui relie des entrées à des résultats selon ses paramètres. L’apprentissage profond est une famille de méthodes utilisant des réseaux de neurones comportant plusieurs couches de traitement. Un réseau neuronal informatique reste un objet mathématique et logiciel.
| Approche | Exemple fictif | Question à poser |
|---|---|---|
| Règles explicites | Signaler une inscription sans adresse de contact. | La règle couvre-t-elle les exceptions métier ? |
| Classification apprise | Classer un message dans plusieurs catégories. | Les exemples représentent-ils les messages futurs ? |
| Prédiction numérique | Estimer le nombre d’inscriptions d’une semaine. | Quelle erreur est acceptable pour l’organisation ? |
| Génération | Proposer un brouillon d’explication de cours. | Comment vérifier le contenu avant son usage ? |
2. Données, exemples et cible
Pour un apprentissage supervisé, un exemple contient des informations d’entrée et une réponse connue, appelée cible ou étiquette. Pour classer des messages, les entrées peuvent être leurs caractéristiques et l’étiquette leur catégorie. D’autres méthodes cherchent des structures sans disposer de ces réponses ou apprennent par interaction avec un environnement. Le choix dépend du problème.
Chez GeniusCampus, on veut trier des demandes administratives en « inscription », « planning » et « assistance ». Les messages fictifs sont étiquetés selon une consigne commune. Si deux personnes classent le même message différemment, l’équipe doit clarifier la règle. Ajouter des milliers d’exemples mal définis ne corrige pas cette ambiguïté.
La qualité des données comprend exactitude, couverture, cohérence et pertinence. Des doublons peuvent fausser les mesures ; des groupes peu représentés peuvent subir plus d’erreurs. Limitez les données aux informations nécessaires et vérifiez les permissions de collecte et d’usage. Un exemple pédagogique doit pouvoir être reproduit sans données personnelles réelles.
3. Entraîner puis évaluer sur des exemples distincts
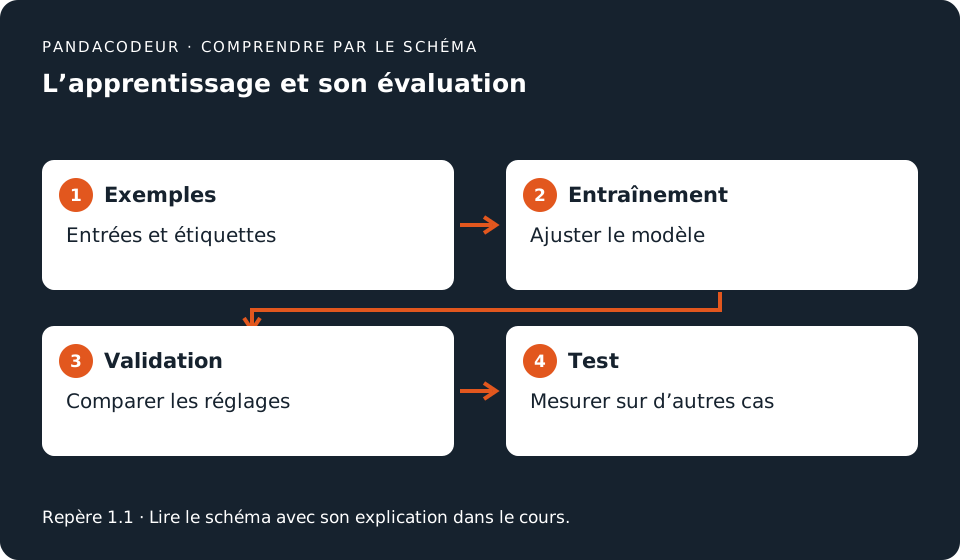
L’entraînement ajuste les paramètres sur un ensemble d’exemples. La validation aide à choisir des réglages et à comparer des options. Un ensemble de test distinct sert à estimer la performance finale sur des cas qui n’ont pas servi à ces choix. La séparation doit respecter le contexte : pour une série temporelle, mélanger passé et futur peut donner une impression trompeuse de performance.
Une fuite de données apparaît lorsqu’une information qui ne devrait pas être disponible entre dans la préparation ou l’évaluation. Exemple : les mêmes messages, légèrement recopiés, se retrouvent en entraînement et en test. Le modèle semble réussir parce qu’il reconnaît les exemples, sans prouver qu’il traite correctement de nouveaux messages.
Le surapprentissage décrit une adaptation trop forte aux exemples d’entraînement, qui généralise mal. On compare les performances sur des données distinctes et on examine les erreurs. Lorsque les habitudes changent, la distribution des données peut changer aussi ; un modèle autrefois satisfaisant doit alors être réévalué.
4. Inférence et critères de réussite
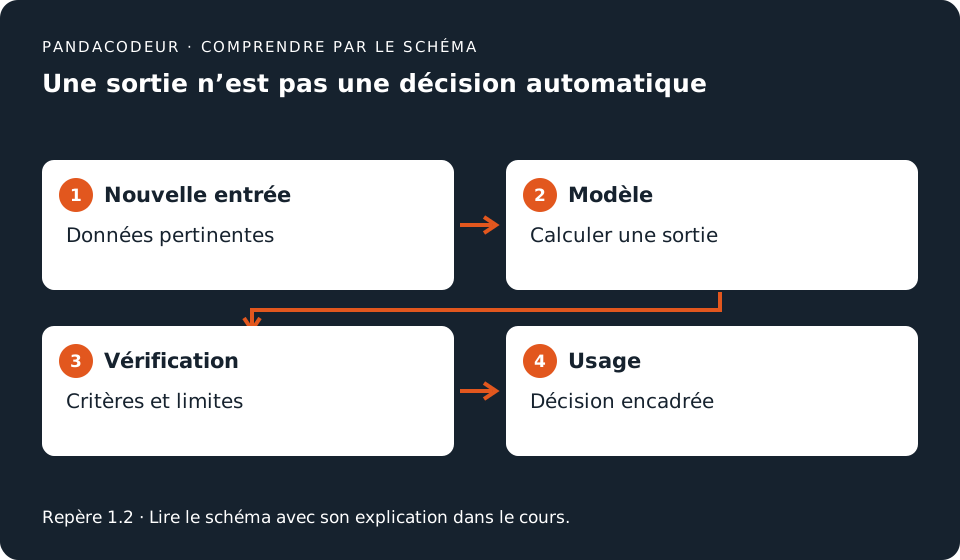
L’inférence utilise le modèle pour produire un résultat sur une nouvelle entrée. Elle ne signifie pas que le modèle apprend automatiquement chaque demande. Une plateforme peut intégrer des procédures de mise à jour, mais leur fonctionnement doit être expliqué séparément. Le modèle n’est qu’une partie du service : l’interface, les données et la décision humaine comptent également.
Un score d’exactitude mesure la proportion de prédictions correctes. Sur 100 messages fictifs, 92 catégories correctes donnent 92 %. Ce score peut masquer des erreurs importantes : si une catégorie urgente est rare, un système peut obtenir un bon score global tout en la reconnaissant mal. Il faut examiner les faux positifs, les faux négatifs et le coût des erreurs pour chaque usage.
Une référence simple aide à juger l’intérêt du modèle. Si 90 messages sur 100 appartiennent à une seule catégorie, annoncer toujours cette catégorie donne déjà 90 % d’exactitude. Passer à 92 % ne suffit pas à démontrer une amélioration utile. L’équipe compare aussi les catégories, la charge de vérification et les cas difficiles.
5. IA générative et vérification
Une IA générative produit un contenu à partir d’un contexte : texte, image ou autre représentation selon le système. Une réponse fluide peut contenir une affirmation inventée ou une référence inexistante. La qualité de présentation ne garantit pas l’exactitude. Demandez des résultats vérifiables et contrôlez les points importants avec des sources fiables ou des calculs reproductibles.
Pour un brouillon de cours, fournissez l’objectif, le niveau et les contraintes, puis relisez les définitions et les exemples. Évitez d’envoyer des secrets ou des dossiers d’étudiants dans un outil dont vous n’avez pas vérifié les conditions. Lorsque la sortie influence une décision importante, définissez clairement le rôle de la vérification humaine et les possibilités de correction.
Une première fiche d’usage tient en cinq lignes : tâche, données, critères, limites et personne qui valide. Pour GeniusCampus, une proposition de catégorie reste une aide au tri ; une personne peut la modifier et signaler une erreur. Nous compléterons ensuite ce cours avec des modèles simples, des ateliers et une étude de l’évaluation.
Exercices et corrigés
Essayez de répondre avant de déplier les corrigés. Les situations et données sont fictives.
1. Distinguer les phases
Un modèle classe un message reçu aujourd’hui sans changer ses paramètres. Quelle phase réalise-t-il ?
Voir le corrigéMasquer le corrigé
Il réalise une inférence. L’entraînement ajuste les paramètres ; utiliser le modèle sur une nouvelle entrée est une opération distincte.
2. Calculer un score
Sur 100 exemples, 92 résultats sont corrects. Quelle exactitude obtient-on et quelle limite garder à l’esprit ?
Voir le corrigéMasquer le corrigé
92 ÷ 100 = 0,92, soit 92 %. Il faut aussi regarder les erreurs par catégorie et la fréquence des cas ; un score global ne décrit pas tout le coût des erreurs.
3. Détecter une fuite de données
Des copies des messages d’entraînement sont placées dans l’ensemble de test. Pourquoi la mesure devient-elle trompeuse ?
Voir le corrigéMasquer le corrigé
Le test ne représente plus des cas indépendants. Le modèle peut reconnaître des exemples déjà vus, ce qui surestime sa capacité à généraliser.
Sources et approfondissements
Sources consultées le 14 octobre 2026. Les cas GeniusCampus et les schémas sont des exemples pédagogiques originaux.
Le cours sera complété progressivement. Le premier chapitre est disponible ; aucun chapitre supplémentaire n’est encore publié.