Accéder au laboratoire pratique et aux trois nouveaux exercices corrigés
Chapitre 6 sur 8. Mises à jour, durcissement, chiffrement des postes, sauvegardes testées et partage cloud : construire une hygiène numérique réaliste.
Objectifs du chapitre
- Établir une configuration de base vérifiable.
- Distinguer synchronisation et sauvegarde.
- Préparer et mesurer une restauration.
1. L’hygiène numérique est une routine
La protection d’un poste commence par un inventaire : propriétaire, système, logiciels, usage et données. Un équipement oublié échappe aux mises à jour et aux décisions de remplacement. Un appareil personnel utilisé pour le travail exige aussi une règle claire : ce qui est permis, comment les données sont séparées et quelle assistance est prévue en cas de perte.
Les mises à jour corrigent notamment des vulnérabilités. Une routine organise la réception des alertes, le test lorsque nécessaire, le déploiement et la vérification. Une version non maintenue pose un problème durable : il faut planifier une migration ou réduire son exposition dans l’attente. « Mise à jour lancée » n’est pas la même chose que « installation réussie sur tous les appareils ».
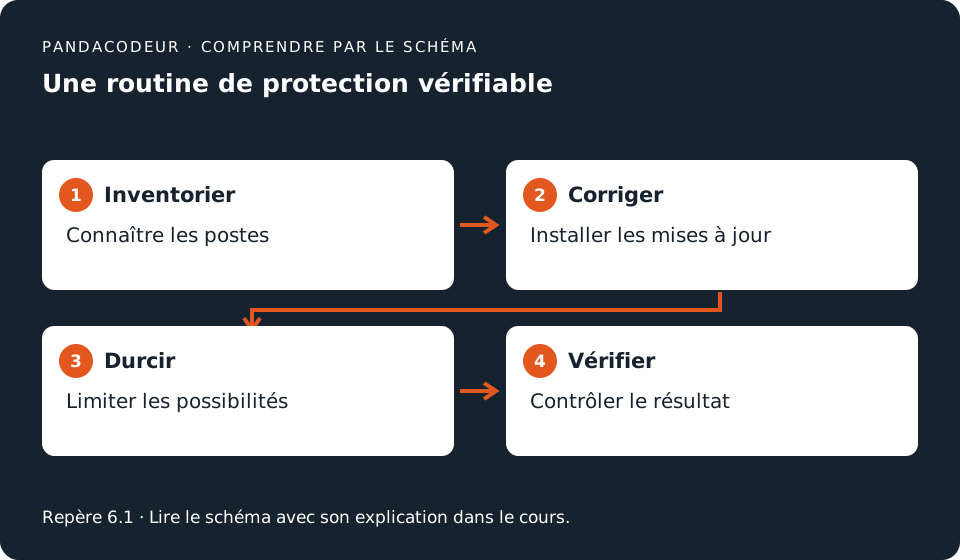
Chez GeniusCampus, un registre distingue les postes pédagogiques et ceux de l’administration. Un pilote de mise à jour est testé sur un poste représentatif, puis le responsable contrôle les versions effectives. Pour une correction urgente, le délai est adapté au risque et au fonctionnement du service. Les reports sont documentés au lieu de devenir des exceptions permanentes.
2. Durcir un appareil
Le durcissement réduit les possibilités inutiles : désinstaller les logiciels non utilisés, désactiver les services superflus, limiter les droits administrateur, verrouiller la session et restreindre les installations. La protection contre les logiciels malveillants reste active et son état est surveillé. Un compte standard pour les tâches courantes limite les conséquences de certaines erreurs, sans rendre tout programme inoffensif.
Le chiffrement du disque protège surtout les données d’un appareil perdu ou volé lorsqu’il est verrouillé ou éteint selon son fonctionnement. Il ne protège pas automatiquement les données lues dans une session déjà ouverte. Sauvegardez les moyens de récupération de façon protégée et testez la procédure avant de déployer le chiffrement sur toute une flotte.
La sécurité physique compte aussi : écran laissé ouvert, documents imprimés, support amovible ou matériel abandonné. Préparez la fin de vie d’un appareil et la suppression adaptée des données. Un simple effacement de fichier n’est pas nécessairement un effacement irréversible sur tous les supports.
3. Sauvegarde et synchronisation
La synchronisation maintient des copies cohérentes entre emplacements. Elle peut propager une suppression ou une modification indésirable. Une sauvegarde vise la restauration de versions conservées selon une politique. Un service synchronisé peut offrir un historique utile, mais il faut vérifier sa rétention, les droits de suppression et les possibilités de récupération.
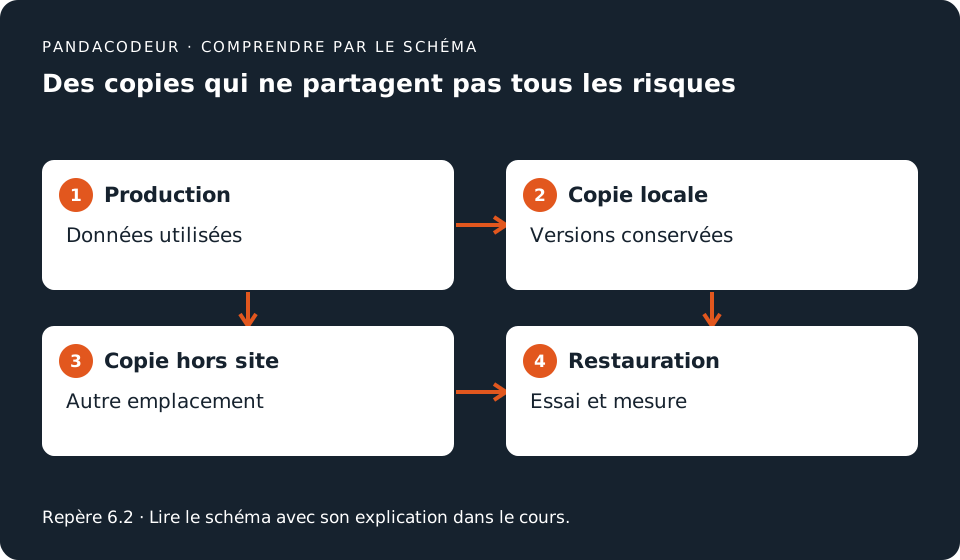
Le repère 3–2–1 invite à conserver plusieurs copies sur des supports ou environnements distincts, avec une copie éloignée ; les formulations et protections supplémentaires varient selon les guides. Pour le cours, retenons trois copies au total, sur deux environnements distincts, avec une copie hors site et une protection hors ligne ou immuable adaptée. La CNIL souligne notamment l’intérêt d’une copie hors ligne. Cette organisation doit résister au scénario étudié : panne, vol, incendie ou compromission des comptes.
Une copie hors ligne est déconnectée lorsque l’on n’effectue pas la sauvegarde. Une copie immuable empêche certaines modifications pendant une durée définie, selon le mécanisme et les permissions. Ni l’une ni l’autre ne dispense de contrôler la réussite, le chiffrement et la récupération des clés. Si tous les dépôts se suppriment avec le même compte, la séparation peut être insuffisante.
4. Mesurer la reprise : RPO et RTO
Le RPO est l’objectif de perte de données maximale acceptable, exprimé en durée. Le RTO est l’objectif de délai de rétablissement. Ce sont des objectifs métier à valider, pas des garanties produites par un logiciel. Il faut vérifier que l’organisation et les tests permettent de les atteindre.
Exemple fictif : une sauvegarde réussit chaque jour à 18 h. Un incident survient le lendemain à 15 h. Si cette copie est la dernière exploitable, 21 heures de modifications peuvent être perdues. Un RPO de 4 heures ne serait donc pas tenu. Si la restauration dure 3 heures, la vérification 1 heure et la remise en service 1 heure, le temps total de reprise est 5 heures. Un RTO de 2 heures ne serait pas tenu non plus.
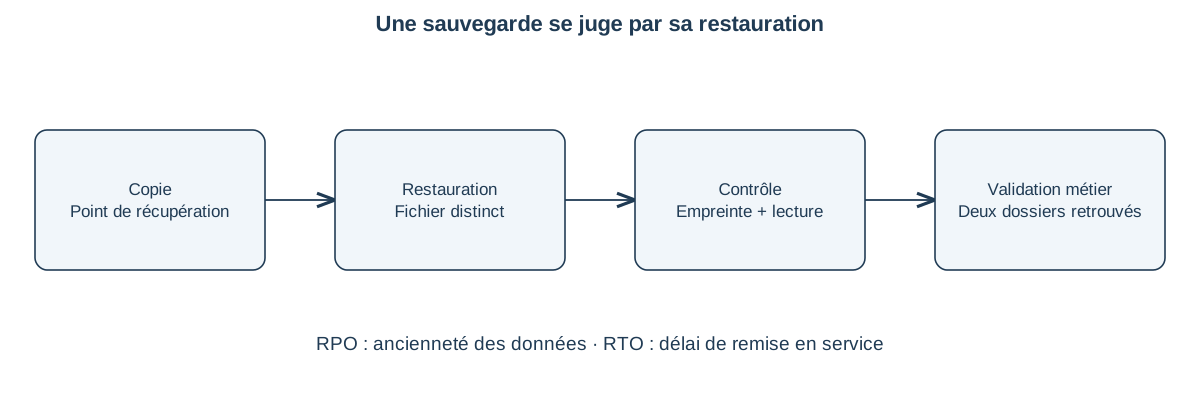
Testez sur une destination isolée : sélectionner une version, restaurer, vérifier les données, ouvrir les services nécessaires et mesurer le temps. Documentez les prérequis, comptes et clés utilisés. Une ligne « sauvegarde OK » prouve une exécution, pas une restauration complète du service.
5. Le cloud conserve des responsabilités côté utilisateur
Un service cloud peut prendre en charge une partie de l’infrastructure, mais les responsabilités varient selon le modèle et le contrat. Les utilisateurs restent notamment concernés par leurs comptes, les permissions, les données partagées et les configurations à leur disposition. Une plateforme bien administrée peut encore héberger un dossier rendu public par erreur.
Pour chaque partage GeniusCampus, choisissez des destinataires identifiés, une durée utile et des permissions limitées. Vérifiez depuis un compte représentatif ce qu’il peut lire et modifier. Évitez les liens publics pour les dossiers sensibles ; examinez les accès externes et les propriétaires absents. Préparez l’export et la récupération si le fournisseur devient indisponible.
Une routine hebdomadaire peut contrôler mises à jour, protection des postes, sauvegardes et incidents ; une revue périodique traite permissions, matériel et tests de reprise. La fréquence dépend des risques. L’objectif est de produire des résultats observables et de corriger les écarts.
Exercices et corrigés
Essayez de répondre avant de déplier les corrigés. Les situations et données sont fictives.
1. Calculer une perte possible
Dernière copie exploitable : lundi 18 h. Incident : mardi 15 h. Quelle période de données est exposée ?
Voir le corrigéMasquer le corrigé
De lundi 18 h à mardi 15 h : 6 heures jusqu’à minuit, puis 15 heures, soit 21 heures. Ce résultat suppose qu’aucun autre journal ou mécanisme de récupération n’est exploitable.
2. Tester la reprise
Votre outil affiche « sauvegarde réussie ». Citez trois vérifications supplémentaires.
Voir le corrigéMasquer le corrigé
Restaurer sur une destination isolée, vérifier la cohérence des fichiers et du service, mesurer le temps total de remise en état. Vérifier également que les clés et les comptes nécessaires restent disponibles.
3. Contrôler un partage
Un lien « toute personne disposant du lien » ouvre les pièces d’identité. Quelle correction proposer ?
Voir le corrigéMasquer le corrigé
Remplacer par un partage à des comptes explicitement autorisés, limiter les droits et la durée, révoquer le lien public puis rechercher les accès passés avec les journaux disponibles.
Sources officielles et approfondissements
Repères consultés le 14 octobre 2026. Les cas GeniusCampus et les schémas sont des exemples pédagogiques originaux.
Pour pratiquer sur PandaCodeur
Laboratoire 6 : Restaurer une sauvegarde et vérifier le service rendu
Objectif : Prouver qu’une copie permet réellement de récupérer des données cohérentes. Durée indicative : 35 minutes.
Une sauvegarde annoncée comme réussie n’est utile que si sa restauration fonctionne. Le laboratoire crée un JSON de deux dossiers, en garde une copie, corrompt volontairement sa version de travail puis restaure un fichier distinct. Toutes les écritures restent dans un dossier temporaire créé pour l’exercice.
Trois niveaux de vérification se complètent : les octets correspondent à la référence, le document est lisible, et les données utiles sont présentes. L’égalité d’une empreinte ne suffit pas si la référence sauvegardée contenait déjà des données incohérentes.
Manipulations guidées
- Ouvrir atelier.py et repérer le dossier temporaire portant le préfixe nkilitech-lab-. Aucun chemin de documents personnels n’est utilisé.
- Lancer restauration depuis un dossier où vous avez le droit d’écrire. Le programme crée ses seuls fichiers de test, puis les nettoie à la fin.
- Vérifier empreinte_identique=true, json_lisible=true et dossiers_restaures=2. Expliquer la valeur de chacun de ces trois contrôles.
- Pour le cas métier, supposer une sauvegarde à 08 h 00 et un incident à 08 h 45. Les opérations postérieures à 08 h 00 peuvent être perdues si aucune autre source ne permet de les rejouer.
- Fixer une cible fictive RPO=30 minutes et RTO=2 heures. Comparer la fenêtre de perte de 45 minutes à la première cible ; mesurer une durée réelle de restauration avant de conclure sur la seconde.
python atelier.py --atelier restaurationRésultats attendus et preuves à conserver
Résultats des trois contrôles, heure du dernier point restaurable, durée de restauration mesurée et liste des vérifications métier. Dans le cas donné, le RPO cible de 30 minutes n’est pas atteint.
Limites de la démonstration
La copie sur le même poste de laboratoire sert seulement à l’exercice. Elle ne représente pas une stratégie de sauvegarde contre panne du poste ou chiffrement malveillant ; il faut des copies et des accès séparés dans une architecture réelle.
Télécharger les ateliers Python complets, le journal fictif et le modèle de rapport · Mode d’emploi et code complet
Trois exercices d’application corrigés
1. Calculer la fenêtre
Dernière copie à 08 h 00, incident à 08 h 45 : quelle fenêtre de données peut manquer ?
Voir le corrigé 1
Jusqu’à 45 minutes d’opérations, sous l’hypothèse qu’aucune copie ou journal exploitable plus récent n’existe. Le RPO cible de 30 minutes est dépassé de 15 minutes dans ce scénario.
2. Séparer RTO et RPO
Une restauration dure 25 minutes. Cela prouve-t-il un RPO de 25 minutes ?
Voir le corrigé 2
Non. La durée de remise en service concerne le RTO. Le RPO concerne l’ancienneté des données que l’on peut récupérer. Une restauration rapide peut remettre en service une copie très ancienne.
3. Détecter une sauvegarde inutilisable
Le hash correspond, mais le JSON ne se charge pas. Que conclure ?
Voir le corrigé 3
La copie peut reproduire fidèlement un fichier déjà invalide. Le test d’intégrité des octets réussit, mais le test de restauration utile échoue. Il faut contrôler la lisibilité et les règles métier avant de déclarer le service rétabli.
Références du laboratoire
Complément original PandaCodeur, cas NKILItech fictif. Les interfaces de WebGoat peuvent évoluer : relever la version et le titre de la leçon suivie.