Accéder au laboratoire pratique et aux trois nouveaux exercices corrigés
Chapitre 3 sur 8. Comprendre IP, DNS, ports, HTTP, HTTPS, pare-feu, VPN et segmentation avec une architecture de réseau commentée.
Objectifs du chapitre
- Expliquer le trajet d’une requête Web.
- Distinguer filtrage, chiffrement et contrôle d’accès.
- Construire une séparation simple des usages réseau.
1. De l’adresse du site à la réponse
Un réseau permet à des équipements d’échanger des données selon des protocoles. Une adresse IP sert à identifier une interface dans un contexte réseau. Un port aide à distinguer les services sur un équipement. Une adresse IP n’identifie pas à elle seule une personne : plusieurs utilisateurs peuvent partager une adresse publique, et un appareil peut changer d’adresse.
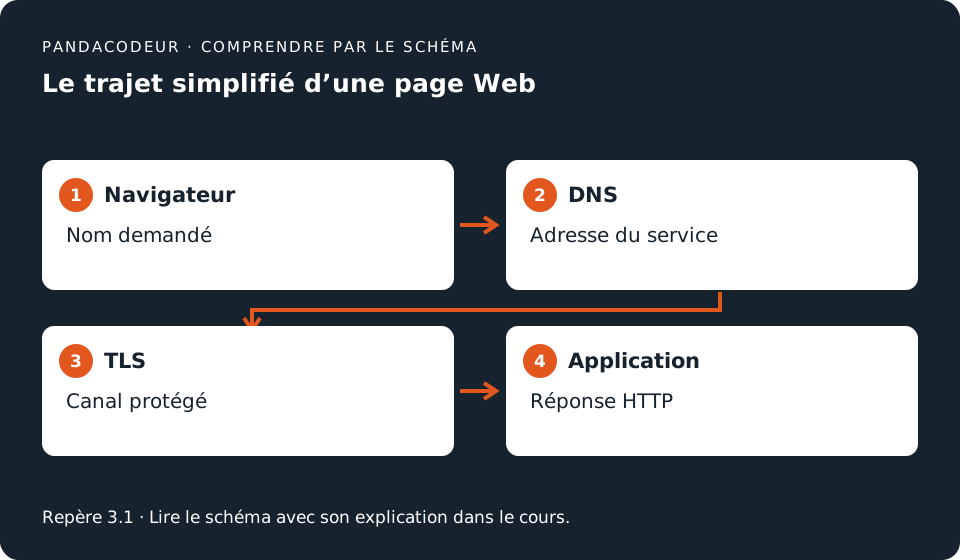
Lorsque vous ouvrez le portail de GeniusCampus, le navigateur doit connaître une adresse du serveur. Le DNS associe notamment des noms à des adresses. La réponse peut être en cache et ne nécessite pas forcément une nouvelle requête à chaque page. Le navigateur établit ensuite une communication avec le service ; pour HTTPS, TLS protège les échanges. Enfin, il envoie une requête HTTP et reçoit une réponse contenant du HTML ou des données.
| Notion | Rôle | Limite à comprendre |
|---|---|---|
| DNS | Retrouver un service à partir d’un nom. | Une résolution correcte ne prouve pas qu’un site est fiable. |
| IP et port | Acheminer vers une interface et un service. | Un port ouvert n’est pas automatiquement une faille. |
| HTTP | Décrire les requêtes et réponses Web. | Sans transport protégé, des données peuvent être observées ou modifiées. |
| TLS / HTTPS | Protéger le canal de communication et authentifier le serveur visé. | Ne corrige pas les failles de l’application. |
2. Le rôle réel de HTTPS
TLS fournit notamment confidentialité et intégrité des données échangées, avec vérification du serveur au moyen de son certificat dans l’usage Web habituel. Le navigateur contrôle la validité du certificat et sa correspondance au nom demandé. Un avertissement de certificat doit être compris et corrigé ; l’ignorer systématiquement supprime une partie de cette protection.
HTTPS ne cache pas nécessairement toutes les métadonnées du trafic. Les adresses des correspondants, les volumes ou certains éléments de résolution peuvent rester observables selon la configuration. Le contenu des pages est protégé sur le trajet TLS, mais il existe en clair dans le navigateur et sur les points où il est traité. Un poste infecté ou un serveur compromis reste donc un risque.
Un VPN crée un tunnel entre des points déterminés. Il peut sécuriser un accès distant au réseau d’une organisation. La confiance se déplace vers le fournisseur ou la passerelle du VPN ; le tunnel ne garantit ni anonymat universel ni absence de malware. L’accès distant doit aussi être authentifié, limité et surveillé.
3. Pare-feu et règles de filtrage
Un pare-feu applique des règles sur le trafic, par exemple selon l’origine, la destination, le protocole ou le contexte de connexion. Un pare-feu réseau protège une frontière ; un pare-feu sur le poste contrôle aussi les communications de cet appareil. Un filtrage « autoriser tout » n’apporte pas la même protection qu’une liste de flux nécessaires documentés.
Pour GeniusCampus, le serveur Web accepte les connexions publiques au service de cours. La base de données n’est joignable que depuis le service applicatif prévu. L’administration passe par un accès distinct réservé à l’équipe informatique. Autoriser un port ne devrait pas devenir une permission de joindre tous les équipements. Les règles doivent avoir un besoin métier, un propriétaire et une révision.
Le principe de refus par défaut consiste à refuser les flux qui ne sont pas explicitement nécessaires. Pour le déployer, on inventorie d’abord les dépendances. Bloquer aveuglément un service peut arrêter les sauvegardes ou les mises à jour. Une règle se vérifie par deux essais : le flux attendu fonctionne, le flux non autorisé est refusé.
4. Segmenter pour limiter les déplacements
La segmentation sépare des groupes d’équipements ou d’usages et contrôle les échanges entre eux. Chez GeniusCampus, les visiteurs utilisent un accès Internet isolé de l’administration. Les postes des enseignants ne communiquent pas librement avec les équipements de sauvegarde. Ainsi, un poste compromis ne reçoit pas automatiquement toutes les possibilités du réseau.
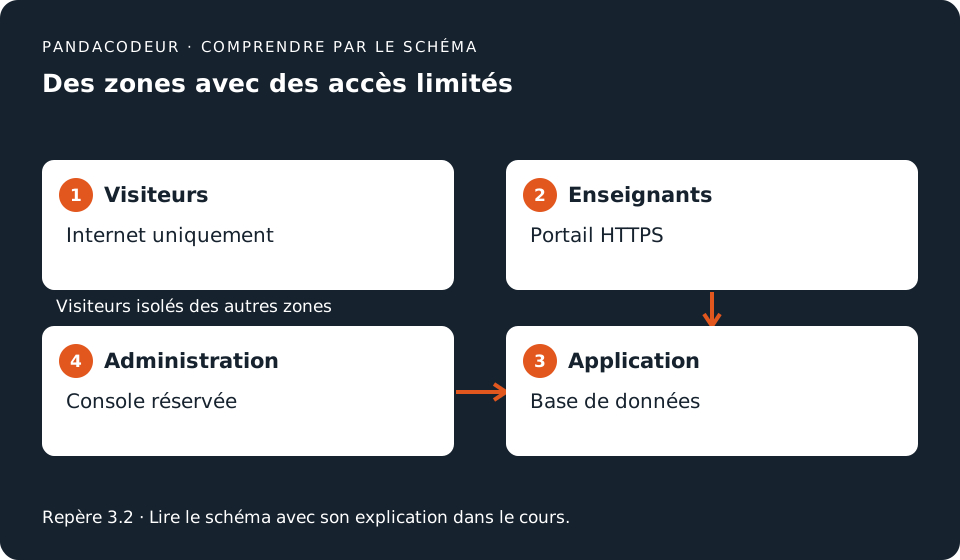
Un VLAN aide à réaliser une séparation logique, mais il ne constitue pas à lui seul une politique de sécurité complète. Les communications entre zones doivent être filtrées ; les erreurs de configuration doivent être recherchées. Le nom du Wi-Fi ou une couleur sur un plan ne prouve pas l’isolement réel. On teste les chemins possibles avec des outils autorisés et des comptes représentatifs.
5. Lire une architecture simple
Dessinez les équipements, les services et les flux nécessaires : navigateur vers portail, portail vers base, administration vers console, sauvegarde vers dépôt. Pour chaque flèche, posez trois questions : qui initie la connexion, comment elle est authentifiée et quelles données circulent ? Marquez les frontières de confiance, par exemple Internet et réseau interne.
L’architecture du schéma est un modèle d’apprentissage ; un hébergement cloud ou une plateforme SaaS peut organiser différemment ces composants. Le raisonnement reste utile : réduire l’exposition, contrôler les chemins et ne pas confondre l’appartenance à un réseau avec l’autorisation d’accéder à toutes ses ressources.
Exercices et corrigés
Essayez de répondre avant de déplier les corrigés. Les situations et données sont fictives.
1. Séparer les services
La base de données doit-elle être directement accessible depuis le Wi-Fi visiteurs ?
Voir le corrigéMasquer le corrigé
Non. L’application accède à la base selon ses besoins ; les visiteurs passent par les fonctions du portail. Un filtrage interzone et des permissions applicatives complémentaires sont nécessaires.
2. Lire une alerte TLS
Le navigateur signale un nom de certificat différent. Quel réflexe adopter ?
Voir le corrigéMasquer le corrigé
Ne pas saisir de secret. Vérifier l’adresse du service, demander au responsable de corriger ou d’expliquer l’alerte et utiliser le canal officiel. Une exception permanente masque un défaut de validation.
3. Évaluer un VPN
Un collègue affirme : « Avec un VPN, mon ordinateur ne peut pas être infecté. » Corrigez cette affirmation.
Voir le corrigéMasquer le corrigé
Le VPN protège un tunnel selon sa configuration. Il ne remplace pas les mises à jour, la protection du poste, la vérification des téléchargements ni le contrôle des accès.
Sources officielles et approfondissements
Repères consultés le 14 octobre 2026. Les cas GeniusCampus et les schémas sont des exemples pédagogiques originaux.
Pour pratiquer sur PandaCodeur
Laboratoire 3 : Observer HTTP et les frontières de confiance avec WebGoat
Objectif : Décrire une requête réelle du laboratoire et identifier les données contrôlées par le navigateur. Durée indicative : 35 à 45 minutes.
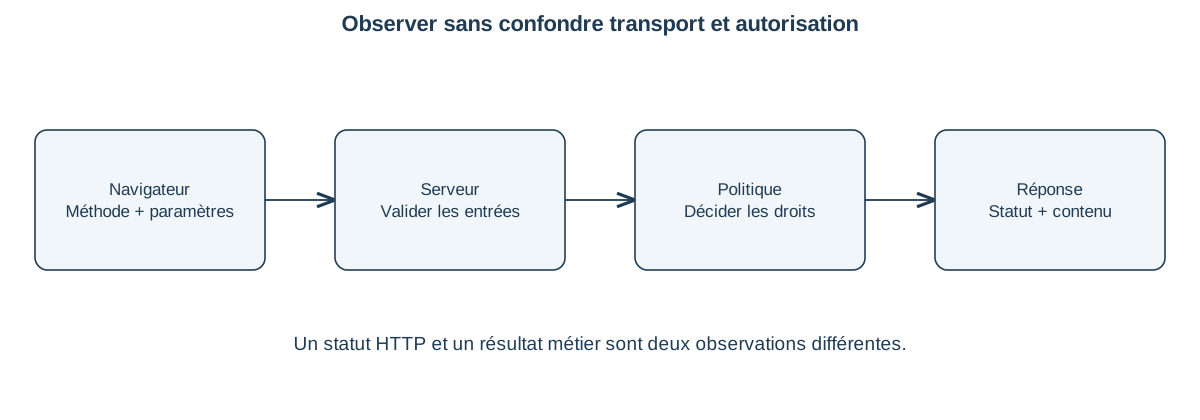
Une requête transporte une méthode, un chemin, des paramètres et des en-têtes ; une réponse comporte un statut, des en-têtes et un corps. Le navigateur peut modifier les valeurs qu’il envoie. Une validation JavaScript facilite la saisie mais ne remplace pas la validation serveur.
Le laboratoire utilise volontairement HTTP sur la boucle locale. Ce choix pédagogique n’est pas une recommandation pour un service réel. TLS protège le transport lorsqu’il est correctement déployé ; il ne transforme pas une valeur client en donnée autorisée.
Manipulations guidées
- Préparer l’instance du chapitre 1 et ouvrir seulement http://127.0.0.1:8080/WebGoat/. Créer un compte fictif propre au laboratoire.
- Ouvrir les outils de développement du navigateur, onglet Réseau. Sélectionner la leçon d’introduction aux requêtes HTTP, généralement nommée HTTP Basics ; les titres et étapes peuvent varier selon l’image.
- Soumettre une valeur demandée par la leçon, puis identifier la méthode, le chemin, le type de contenu et la valeur envoyée. Ne pas exporter les en-têtes Cookie ou Authorization dans le compte rendu.
- Comparer deux saisies autorisées par la leçon et noter ce qui change. Utiliser uniquement les paramètres et manipulations prévus dans cet exercice local ; aucune requête n’est envoyée à un service extérieur.
- Pour chaque champ observé, distinguer information d’affichage, donnée métier et décision d’accès. Rédiger ce que le serveur doit vérifier même si la page semble correcte.
Résultats attendus et preuves à conserver
Une fiche expurgée : méthode, chemin local, paramètre de démonstration, statut, observation et contrôle serveur attendu. Ajouter le titre exact de la leçon et le digest du conteneur.
Limites de la démonstration
Un statut 200 n’est pas une preuve d’autorisation correcte. Un cookie de session constitue un secret même dans un rapport de test ; ne pas le publier avec une capture ou un fichier HAR.
Télécharger les ateliers Python complets, le journal fictif et le modèle de rapport · Mode d’emploi et code complet
Trois exercices d’application corrigés
1. Identifier la confiance
Un champ caché role contient agent. Le serveur doit-il le croire ?
Voir le corrigé 1
Non. Un champ caché reste une donnée du navigateur. Le rôle doit provenir d’une identité authentifiée et de droits déterminés côté serveur ; les attributs fournis par le client ne suffisent pas.
2. Lire une réponse
Une page répond 200 avec « accès refusé ». Comment consigner le résultat ?
Voir le corrigé 2
Noter séparément le statut HTTP et le résultat métier observé. Le statut est peu explicite ici, mais la présence d’un refus ne prouve pas que toutes les données sensibles sont absentes du corps : il faut aussi inspecter la réponse.
3. Partager une trace
Que retirer avant de joindre une capture de requête au rapport ?
Voir le corrigé 3
Retirer cookies, jetons, mots de passe et informations personnelles. Conserver les noms de champs et des valeurs fictives suffisantes pour comprendre le test. Vérifier aussi les URL, qui peuvent contenir des paramètres sensibles.
Références du laboratoire
Complément original PandaCodeur, cas NKILItech fictif. Les interfaces de WebGoat peuvent évoluer : relever la version et le titre de la leçon suivie.