CHAPITRE 5 : LES SEPT FAMILLES DE CROISSANCE
Presque tous les algorithmes que vous écrirez tombent dans l'une de sept familles. Les connaître de vue, c'est savoir en un coup d'œil si un programme tiendra la charge.
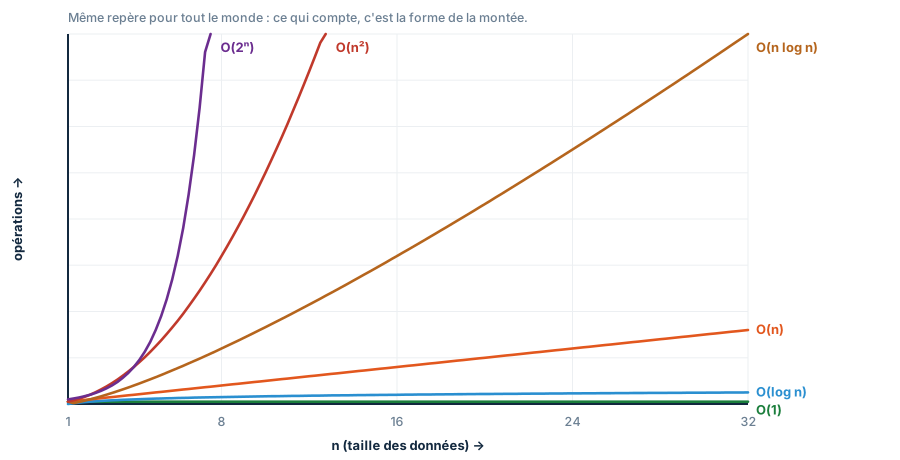
O(1) : constant
Le travail ne dépend pas du tout de la taille des données. Dix éléments ou dix millions, c'est le même coût.
tab[742]            # accès direct à une case
dico["matricule"]   # recherche dans un dictionnaire
pile.append(x)      # empiler
C'est le Graal, et il est plus souvent accessible qu'on ne croit : remplacer une liste par un dictionnaire transforme une recherche linéaire en recherche constante.
O(log n) : logarithmique
À chaque étape, on élimine une fraction de ce qui reste : la moitié, le plus souvent.
def dichotomie(tab, x):
    debut, fin = 0, len(tab) - 1
    while debut <= fin:
        milieu = (debut + fin) // 2
        if tab[milieu] == x:
            return milieu
        elif tab[milieu] < x:
            debut = milieu + 1      # la moitié gauche disparaît
        else:
            fin = milieu - 1        # la moitié droite disparaît
    return -1
Le logarithme grandit si lentement qu'il paraît presque constant. Pour un million d'éléments, 20 étapes. Pour un milliard, 30. Multiplier les données par mille n'ajoute que dix étapes.
Pourquoi on n'écrit pas la base. Passer de log₂ à log₁₀, c'est multiplier par une constante (environ 3,32). Or on jette les constantes. En complexité, log n sans base signifie « logarithme, peu importe laquelle » : même si en informatique c'est presque toujours la base 2.
O(n) : linéaire
On touche chaque élément une fois. Doubler les données double le travail.
def maximum(tab):
    m = tab[0]
    for x in tab:        # chaque élément, une fois
        if x > m:
            m = x
    return m
C'est souvent le mieux qu'on puisse espérer : pour trouver le maximum d'une liste non triée, il faut bien regarder chaque valeur, en ignorer une, c'est risquer de rater le maximum.
O(n log n) : quasi-linéaire
On découpe le problème en deux, on traite chaque moitié, on recombine. Il y a log n niveaux de découpage, et chaque niveau coûte n.
C'est la complexité des bons tris : tri fusion, tri par tas, et le tri standard de Python ou de Java. On a démontré qu'aucun tri par comparaisons ne peut faire mieux.
En pratique, n log n est à peine plus cher que n. Pour un million d'éléments, le facteur log n ne vaut que 20.
O(n²) : quadratique
Chaque élément est confronté à chaque autre. C'est la signature de la double boucle imbriquée.
for i in range(n):
    for j in range(n):
        ...
Doubler les données quadruple le travail. Tolérable jusqu'à quelques milliers d'éléments, pénible à cent mille, impossible au million.
C'est la famille où se cachent la plupart des programmes qui « marchaient très bien en test » et s'effondrent en production.
O(2ⁿ) : exponentiel
Ajouter un seul élément double le travail. On la rencontre dès qu'on explore toutes les combinaisons possibles.
def sous_ensembles(liste):
    if not liste:
        return [[]]
    reste = sous_ensembles(liste[1:])
    return reste + [[liste[0]] + s for s in reste]
    # 2ⁿ sous-ensembles : il y en a 2ⁿ, on ne peut pas faire moins
À n = 20, c'est encore jouable. À n = 50, c'est fini : aucune machine existante ou future n'y arrivera.
O(n!) : factoriel
Pire encore. On la rencontre quand on examine tous les ordres possibles, comme dans la version naïve du voyageur de commerce.
20! vaut déjà 2,4 milliards de milliards. Au-delà d'une douzaine d'éléments, il faut une autre approche.
Ce que cela donne en secondes
Les familles dans l'abstrait, c'est bien. Les durées réelles, c'est mieux.
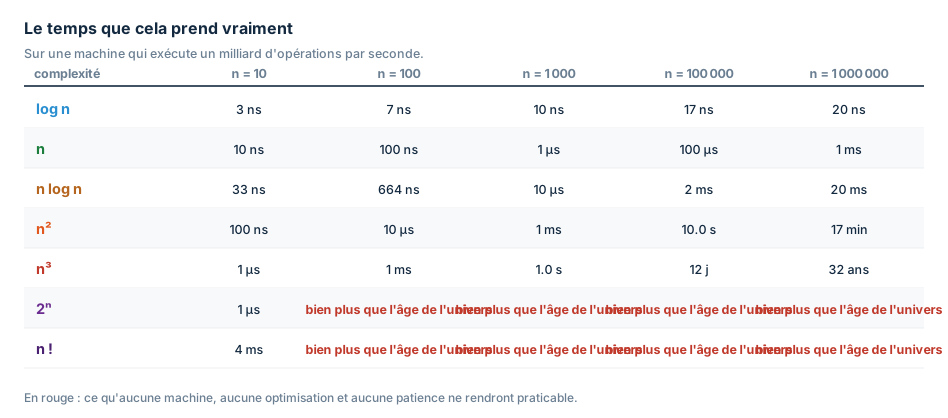
Lisez ce tableau attentivement, c'est le plus utile du cours. Trois observations :
- Jusqu'à n log n, un million d'éléments reste instantané.
- n² passe de « imperceptible » à un quart d'heure entre cent mille et un million. C'est là que les programmes meurent.
- 2ⁿ et n! dépassent l'âge de l'univers dès une centaine d'éléments. Pas « c'est lent » : c'est impossible, définitivement.
À retenir
- O(1) et O(log n) : la taille n'a pratiquement pas d'importance.
- O(n) et O(n log n) : confortables jusqu'à des millions d'éléments.
- O(n²) : convenable jusqu'à quelques milliers, puis ça se gâte vite.
- O(2ⁿ) et O(n!) : au-delà de quelques dizaines d'éléments, il faut changer de méthode, pas de machine.
Exercices d'application
Voir le corrigeMasquer le corrige
Multiplier la taille par k multiplie le travail par k².
1 000 -> 10 000     : x10   -> x100   -> 100 s, soit 1 min 40
1 000 -> 1 000 000  : x1000 -> x1000000 -> 1 000 000 s
Un million de secondes font environ 11 jours et demi.
C'est tout l'intérêt du raisonnement : à partir d'une seule mesure et de la famille de complexité, on prévoit, sans attendre onze jours pour le constater.
Voir le corrigeMasquer le corrige
Trois options, selon ce qu'on accepte de payer d'avance.
| Méthode | Préparation | Par recherche |
|---|---|---|
| Parcours de la liste | aucune | O(n) : 100 000 comparaisons |
| Trier, puis dichotomie | O(n log n), une fois | O(log n) : 17 comparaisons |
Table de hachage (set) | O(n), une fois | O(1) : quasi immédiat |
Pour des recherches répétées, la table de hachage l'emporte : en Python, un simple set(noms) construit une fois pour toutes.
La dichotomie garde un avantage que le hachage n'a pas : la liste reste triée, donc on peut aussi demander « tous les noms entre Awa et Bello ». Le bon choix dépend des questions qu'on compte poser.
Voir le corrigeMasquer le corrige
Parce que les deux ne réagissent pas du tout de la même façon à un ordinateur plus rapide.
Avec une machine mille fois plus rapide :
- en O(n²), on traite environ 32 fois plus de données dans le même temps : racine de 1 000 ;
- en O(2ⁿ), on traite 10 éléments de plus. Dix. Parce que 2¹⁰ ≈ 1 000.
Un problème quadratique recule devant le matériel. Un problème exponentiel l'ignore : si vous êtes bloqué à n = 45, une machine mille fois plus rapide vous emmène à n = 55. Il faut changer d'algorithme, pas de machine.
Cherchez avant d'ouvrir le corrige : c'est en butant sur les difficultes que l'on progresse.
Questions / Réponses
Ajouter un commentaire