Chapitre 1 disponible · Cours en construction. Comprendre le Big Data : volume, vitesse, diversité, pipeline de données, traitements par lots et flux, qualité et gouvernance.
Objectifs du chapitre
- Expliquer les contraintes qui motivent le Big Data.
- Lire un pipeline de données et distinguer lot et flux.
- Relier qualité, coût et protection des données.
1. Le Big Data répond à des contraintes
Le Big Data concerne des données et des traitements dont les caractéristiques exigent une architecture capable de passer à l’échelle. Il ne se résume pas à un fichier volumineux et il n’existe pas un seuil de taille valable pour tous les systèmes. Une contrainte peut venir de la quantité de données, de leur vitesse d’arrivée, de leurs formats ou de leur variabilité.
Les repères souvent présentés comme les « V » aident à poser les questions : volume à conserver, vitesse à traiter, variété des formats et variabilité des comportements. D’autres présentations ajoutent la véracité et la valeur. Ce sont des grilles de lecture, pas un compteur de conditions obligatoire pour chaque projet.
| Dimension | Question | Exemple fictif |
|---|---|---|
| Volume | Combien de données conserver et lire ? | Historique de mesures de capteurs sur plusieurs années. |
| Vitesse | À quelle cadence arrivent-elles et quand faut-il répondre ? | Événements transmis en continu par des équipements. |
| Variété | Quels formats et significations faut-il rapprocher ? | Tableaux, journaux et documents textuels. |
| Variabilité | Le rythme ou la distribution changent-ils ? | Pic d’activité pendant une campagne d’inscription. |
Avant d’adopter un système distribué, essayez de définir la question et de mesurer les volumes réels. Une base relationnelle et des traitements simples peuvent être suffisants. Multiplier les composants sans besoin crée des coûts, des dépendances et des difficultés d’exploitation.
2. Du besoin au pipeline
Un pipeline organise les étapes de circulation et de transformation des données. Chez GeniusCampus, on veut suivre la fréquentation des cours sans identifier inutilement les personnes. Les sources fournissent des événements fictifs, une étape vérifie leurs champs, un stockage conserve les données utiles, puis un calcul produit un tableau de bord agrégé.
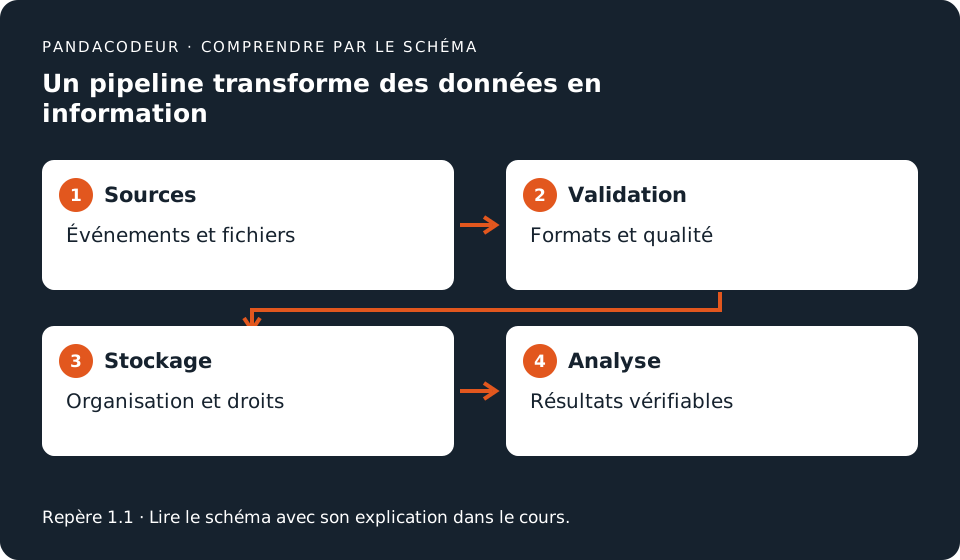
Chaque étape doit préciser le schéma attendu, les erreurs possibles et le responsable. Une date peut manquer, un événement peut arriver deux fois ou un identifiant de cours peut être inconnu. Placer les données brutes dans un stockage ne garantit pas que les résultats sont exploitables. Il faut définir comment traiter les données rejetées et vérifier les corrections.
Un entrepôt de données organise généralement des données préparées pour l’analyse. Un lac de données conserve des formats plus variés avec une organisation qui doit rester gouvernée. Les architectures réelles peuvent combiner ces approches. Les noms ne dispensent ni de documenter les jeux de données ni de contrôler les permissions.
3. Traitement par lots et traitement en flux
Un traitement par lots travaille sur un ensemble disponible : calculer chaque nuit les inscriptions de la journée. Un traitement en flux traite les événements au fur et à mesure de leur arrivée, avec des états et des fenêtres de temps selon le besoin. Un flux n’est pas nécessairement instantané ; le délai acceptable doit être défini.
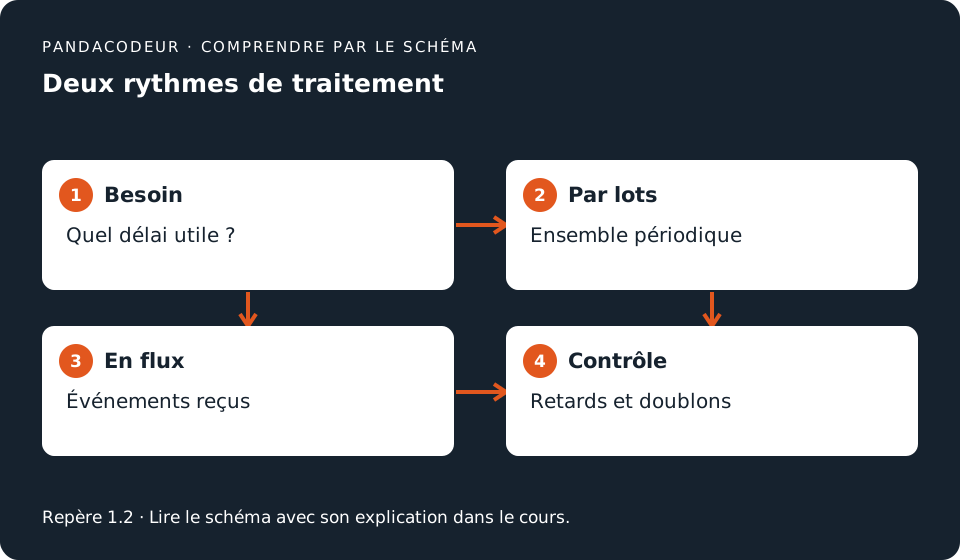
Les événements peuvent arriver en retard ou dans un ordre différent de celui où ils ont été produits. Une agrégation sur la dernière heure doit préciser si elle utilise l’heure de l’événement ou celle de sa réception. Un traitement doit aussi gérer les doublons et les reprises après interruption. La promesse d’un calcul ne suffit pas : il faut expliquer ce qu’il compte réellement.
Pour un rapport quotidien sans urgence, le lot simplifie souvent l’exploitation. Pour détecter rapidement une variation de température sur un équipement, un traitement en flux peut être utile. Le choix se justifie par la décision attendue, les délais et les moyens disponibles.
4. Répartir le travail et comprendre les coûts
Le partitionnement répartit les données en ensembles plus petits, par exemple par date. Le traitement parallèle utilise plusieurs unités de calcul. La réplication conserve plusieurs copies pour des objectifs de disponibilité ; elle augmente aussi stockage et transferts. Une répartition déséquilibrée peut laisser une unité traiter presque tout le travail pendant que les autres attendent.
Calcul fictif : 500 capteurs produisent chacun 2 événements par minute. Cela donne 1 000 événements par minute et 1 440 000 par jour, car une journée comporte 1 440 minutes. À 200 octets par événement, le contenu représente 288 000 000 octets par jour, soit 288 Mo décimaux. Ce calcul exclut index, métadonnées, compression et réplication ; il ne constitue pas une facture de stockage.
Si l’activité double, la charge ne double pas forcément dans tous les composants : certains coûts sont fixes, certains transferts se multiplient et des limites peuvent être atteintes. Mesurez les temps, la mémoire, les volumes lus et les reprises. La performance doit être testée sur un jeu représentatif, avec un critère de réussite.
5. Qualité, traçabilité et gouvernance
La qualité se vérifie avec des règles mesurables : champs obligatoires, valeurs plausibles, doublons et cohérence entre sources. Un taux de valeurs manquantes ne dit pas à lui seul si les résultats sont acceptables. Une colonne manquante systématiquement dans un groupe peut produire un biais important, même si le taux global paraît faible.
La traçabilité, parfois appelée lignage des données, décrit l’origine et les transformations d’un résultat. Pour expliquer un graphique, on doit retrouver les sources, les filtres et les versions de calcul. Un résultat reproductible permet de rechercher une erreur et de comparer des changements de méthode.
La gouvernance fixe les responsables, les droits, les durées de conservation et les règles d’usage. Collecter plus de données n’est pas toujours plus utile. Pour GeniusCampus, des statistiques agrégées peuvent répondre au besoin de fréquentation sans conserver tous les détails individuels. Les sauvegardes, la suppression et la surveillance des partages font aussi partie du projet.
Ce premier chapitre pose les repères. Nous compléterons le cours avec la préparation des données, les architectures distribuées et des ateliers reproductibles. Pour débuter, dessinez un pipeline de quatre étapes et notez, pour chacune, son entrée, sa sortie et sa vérification.
Exercices et corrigés
Essayez de répondre avant de déplier les corrigés. Les situations et données sont fictives.
1. Choisir un rythme
Un rapport doit être disponible chaque matin, sans alerte immédiate. Quel traitement considérer d’abord ?
Voir le corrigéMasquer le corrigé
Un traitement par lots planifié peut répondre au besoin avec moins de complexité. Il faut vérifier sa durée, sa réussite et sa reprise en cas d’échec.
2. Recalculer le volume
500 capteurs envoient 2 événements par minute, de 200 octets chacun. Quel volume de contenu obtient-on en 24 heures ?
Voir le corrigéMasquer le corrigé
500 × 2 × 60 × 24 = 1 440 000 événements. Multiplier par 200 donne 288 000 000 octets, soit 288 Mo décimaux, avant les surcoûts et la compression.
3. Vérifier un résultat
Un tableau de bord compte deux fois certains événements reçus après une interruption. Quel point du pipeline examiner ?
Voir le corrigéMasquer le corrigé
La reprise et la gestion des doublons. Il faut définir une identité d’événement ou une règle adaptée, puis vérifier que la répétition d’un traitement ne crée pas un compte erroné.
Sources et approfondissements
Sources consultées le 14 octobre 2026. Les cas GeniusCampus et les schémas sont des exemples pédagogiques originaux.
Le cours sera complété progressivement. Le premier chapitre est disponible ; aucun chapitre supplémentaire n’est encore publié.